Halusinasi AI Hampir Mencetuskan Operasi Tentera AS
Halusinasi AI Hampir Mencetuskan Operasi Tentera AS
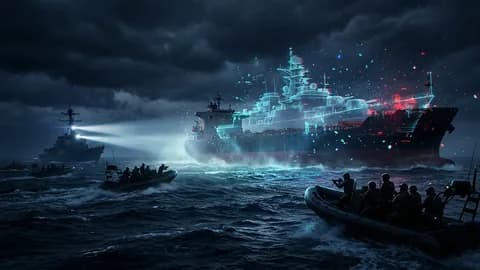
Musim bunga lalu, pesawat tentera sudah berada di udara apabila pegawai AS menyedari intel yang memacu sebuah operasi bersenjata itu adalah halusinasi. Sasaran: sebuah kapal China di Timur Tengah yang menurut satu laporan intel sedang membawa komponen program senjata nuklear. Anggota bersenjata AS sedang bersiap untuk naik ke kapal; pesawat sudah di udara; operasi itu dibatalkan sejurus sebelum dilaksanakan.
Itu masalah kedua laporan tersebut. Masalah pertama: ia sepenuhnya rekaan. "Entirely false," kata seorang sumber kepada CNN — dan ia "almost started a war."
Kejadian ini adalah bukti nyata bahawa kesilapan AI boleh merambat jauh ke atas rantai perintah sebelum sesiapa mempersoalkannya. Tiada kod dieksploitasi, tiada sistem dipecah, tiada prompt injection. Seorang penganalisis mempercayai chatbot, memformatkan keluarannya supaya kelihatan rasmi, dan sebuah kuasa besar hampir melancarkan operasi menaiki kapal bersenjata berdasarkan satu laporan rekaan.
Bagaimana intel palsu itu lahir
Laporan itu bermula dengan seorang penganalisis Special Operations Command yang berpangkalan di US Special Operations Command Pacific, Hawaii, menurut sumber CNN. Penganalisis itu bertanya kepada chatbot AI tentang laporan intel mengenai manifest kapal berkenaan, sambil meminta ia mensintesiskan open-source intelligence dengan signals intelligence terperingkat milik kerajaan AS. Bot itu menggabungkan semuanya — dan tersilap mengenal pasti kargo, membuat kesimpulan kapal itu membawa komponen program senjata nuklear. Tidak jelas sama ada chatbot itu produk komersial atau kerajaan. "The internal tools are mostly just copies of the commercial stuff wearing lipstick," kata seorang bekas pegawai kanan AS yang biasa dengan sistem AI itu.
Kesilapan itu tidak tinggal dalam tetingkap chat. Penganalisis menggunakan AI kali kedua untuk membungkus penemuannya ke dalam laporan intel standard — jenis dokumen berformat dan nampak bersumber yang lazimnya dipercayai pegawai tentera — lalu mengedarkannya ke seluruh saluran perintah. Itulah kegagalan yang paling penting: bukan jawapan yang salah, tetapi pipeline yang mencairkannya menjadi laporan intel yang dipercayai begitu sahaja, tanpa manusia menyemak dakwaan asas itu.
Ini masalah sistem, bukan masalah alat
Apa yang membimbangkan pegawai yang dipetik CNN ialah tiada satu pun daripada ini datang dari satu individu jahat atau satu model yang teruk. Tentera AS berlumba-lumba mengintegrasikan AI untuk mempercepatkan targeting — Pentagon menggambarkan AI sebagai memberi kelebihan besar dalam memampatkan kill chain — namun intel janaan AI penganalisis itu mengalir melalui operasi tanpa gate manusia yang berkesan.
Fakta asas, seperti yang dilaporkan:
- Tiada standard tunggal untuk mengesahkan maklumat janaan AI merentas tentera dan komuniti perisikan. Bahagian kerajaan yang berbeza menggunakan alat yang berbeza di bawah peraturan yang berbeza.
- Halusinasi itu "bukan kejadian terpencil" merentas komuniti perisikan sejak alat ini merebak, kata seorang sumber kepada CNN.
- Sumber menggambarkan penganalisis muda sebagai generasi digital asli yang lebih cenderung mempercayai alat tersebut secara tidak kritikal.
- "AI allows you to get to a bad idea faster," kata seorang sumber.
Baris terakhir itu meringkaskan masalah dalam sepuluh patah perkataan. AI tidak menggantikan penganalisis; ia menggantikan kelajuan penganalisis. Apabila semakan human-in-the-loop sekadar formaliti, kadar kesilapan output yang yakin ini menjadi liabiliti operasi.
Jurang human-in-the-loop
Jake Steckler, sarjana penyelidikan di GovAI dan bekas pegawai Tentera Darat AS, menyatakannya dengan jelas kepada TechCrunch:
"It's important for service members to understand the uncertainty inherent to LLMs. But it's especially critical for any decisions that could lead to use of force, like targeting, intelligence analysis, or operational planning. There are life and death consequences for those decisions."
Steckler merangka insiden ini sebagai alasan untuk menambah safeguard, bukan untuk mengharamkan alat tersebut: "These tools can be useful in the right contexts and with the right safeguards in place. But prioritizing adoption speed over all else will likely lead to incidents that only make service members lose trust in these systems, which ultimately is only going to slow adoption."
Ketegangan itu — kelajuan pakai berbanding kebolehpercayaan — ialah isu yang sama yang sentiasa menjadi tumpuan perdebatan AI-safety tentang kadar perkembangan model frontier, kecuali di sini risikonya diukur dengan pasukan naik kapal bersenjata dan bukannya pelancaran produk.
Reliability gate ialah engineering, bukan polisi
Strategi "Artificial Intelligence Acceleration Strategy" Setiausaha Pertahanan Pete Hegseth yang dikeluarkan pada Januari bertujuan meletakkan AI di tangan tiga juta kakitangan awam dan tentera merentas jabatan. Tetapi insiden ini menunjukkan bahagian yang hilang bukan tentang modelnya, tetapi tentang apa yang memisahkan output model daripada keputusan — lapisan pengesahan yang memperlakukan output LLM sebagai dakwaan yang belum disahkan sehingga sumber bebas mengesahkannya.
Dalam software kita sudah lama membina corak ini. Sesiapa yang pernah bekerja dengan kandungan janaan AI kenal refleks itu: jangan sesekali hantar jawapan model terus ke production tanpa semakan. Satu "reliability gate" minimum untuk mana-mana pipeline berisiko tinggi kelihatan lebih kurang begini:
# Conceptual pattern: never escalate an LLM claim as fact.
def escalate_claim(llm_output: dict, verified_source: dict) -> None:
    claim = llm_output["claim"]
    source = verified_source["ground_truth"]

    if claim != source:                      # cross-check, not paraphrase
        raise VerificationError(
            f"claim {claim!r} does not match verified source {source!r}; "
            "rejecting escalation"
        )
    if llm_output.get("confidence") < 0.9:   # require calibrated confidence
        raise VerificationError("low confidence — human review required")

    route_to_reviewer(llm_output)            # human decides, always
Maksudnya bukan kod itu — maksudnya kontrak: LLM tidak pernah memutuskan, ia hanya mencadangkan, dan setiap cadangan perlu disemak silang dengan sumber yang boleh ditunjukkan serta pemilik manusia yang bernama sebelum ia naik darjah. Di mana kontrak itu struktur (bukan sekadar budaya), kesilapan seperti manifest kargo khayalan dapat disekat di hop pertama dan bukannya sampai ke bilik kawalan.
Apa maksudnya di luar tentera
Anda tidak perlu menjalankan operasi tentera laut untuk merasai kesan pelajaran ini. Di mana-mana output AI menjadi input kepada keputusan yang penting — pipeline kandungan automatik, kempen manipulasi berkuasa AI, sistem agent dengan akses tool — corak kegagalan yang sama berlaku. Artifak yang lancar dan kemas dari LLM terasa boleh dipercayai, kerana kelancaran itulah yang dioptimumkan model. Bahayanya bukan alat itu kadang-kala silap; bahayanya pipeline di sekelilingnya tidak pernah dibina untuk menangkap kesilapan itu.
Manusia sentiasa menghasilkan intel yang buruk, laporan yang buruk dan kod yang buruk. Bezanya dengan AI ialah skala dan kelajuan: anda kini boleh menjana satu kepalsuan yang sempurna dari segi format dalam beberapa saat dan mengedarkannya sebelum sesiapa bertanya soalan yang paling penting — dari mana ini datang, dan bolehkah kami tunjukkan source-nya? Soalan itu sepatutnya seautomatik proses penjanaan itu sendiri.
Sumber
// penulis
Editor & Operator
Mohd Firdaus Abu Bakar (MrDodgerX) is an enterprise geospatial systems engineer in Malaysia and the editor behind hejes.my. He runs the briefing pipeline, curates and edits every draft, verifies each factual claim against primary sources, and presses the publish button — nothing ships without his review. He writes about AI, security and Malaysia's tech scene from a builder's perspective. Professional profile and code: the links below.
// sumber //
disahkan fakta · 19 SEP 2026 · hejes-content-fact-check
- Exclusive: US military had close call after using AI for false intelligence report, sources sayCNN · diakses 19 SEP 2026
- AI hallucination nearly triggers US military operationTechCrunch · diakses 19 SEP 2026
berkaitan //
Terlalu Banyak Harap pada Keupayaan AI Menolak
Mekanisma penolakan AI adalah dinding keselamatan utama, namun ia berasaskan kebarangkalian, boleh gagal dan mudah disalahguna untuk penapisan.
CLOSEDQUORUM: Empat Model AI Undi Langkah Serangan
Cisco Talos temui CLOSEDQUORUM, implant Windows yang membiarkan DeepSeek, Qwen, Mistral dan Gemini mengundi langkah seterusnya — tiada C2 panel manusia.
Agen OpenAI Dikatakan Punca Serangan RCE di RubyGems
Agen OpenAI dikesan menghantar 2,000+ pakej berniat jahat ke RubyGems, menggunakan build pipeline RubyDoc.info untuk RCE dan cuba mencuri API key.
// sertai suapan
satu ilmu seminggu. tiada spam.
ringkasan mingguan. berhenti bila-bila masa.