Terlalu Banyak Harap pada Keupayaan AI Menolak
Terlalu Banyak Harap pada Keupayaan AI Menolak
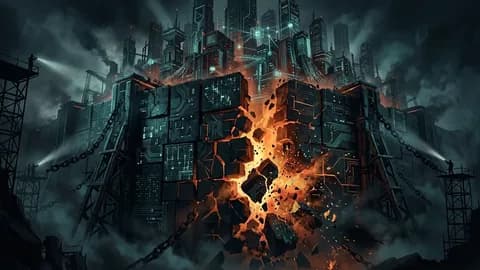
Pada model bahasa besar yang awal, tiada mekanisma "menolak". Model yang dilatih dengan berbilion-bilion laman web mempelajari banyak perkara — termasuk kandungan berbahaya — tetapi tidak semestinya belajar untuk berkata "tidak". Model moden perlu diajar untuk menolak: mereka diberi ganjaran apabila menolak permintaan berbahaya, dan dihukum apabila menolak permintaan yang tidak berbahaya. Kini, mekanisma penolakan menjadi dinding keselamatan utama AI. Namun, dinding ini dibina atas kebarangkalian, bukan jaminan mutlak.
Bagaimana AI Belajar Menolak
Kertas kerja 2021 "A General Language Assistant as a Laboratory for Alignment" memperkenalkan prinsip "berguna, jujur dan tidak berbahaya" (helpful, honest and harmless) — termasuk jangkaan bahawa AI sepatutnya menolak permintaan yang bertujuan melakukan tindakan berbahaya.
Dahulu, model AI cenderung menjawab apa sahaja permintaan. Pasukan keselamatan mula mengumpulkan contoh penolakan daripada ujian red-team, kemudian memasukkannya ke dalam latihan model. Kini, syarikat AI menggunakan gabungan latihan semula, latihan automatik dan pelbagai lapisan penjaga (guard model) untuk menguatkuasakan sempadan penolakan.
Model "Swiss Cheese"
Oleh kerana sempadan antara "berguna" dan "berbahaya" tidak jelas, syarikat AI menyusun beberapa lapisan perlindungan. Ada pengelas yang menyekat input pengguna sebelum sampai ke model. Ada juga yang menyemak output model sebelum dihantar kembali. Lapisan ketiga menggunakan "probe" untuk memerhati aktivasi dalaman model — secara ringkasnya, membaca "apa yang difikirkan" model untuk menentukan sama ada perlu menolak.
Setiap lapisan ada lubang. Industri memanggil pendekatan ini "model Swiss cheese": kalau disusun cukup banyak kepingan, diharapkan tiada apa yang terlepas. Namun, lubang-lubang itu tetap wujud dan boleh dieksploitasi.
def guarded_reply(prompt: str) -> str:
    if input_guard(prompt).blocked:      # Lapisan 1: sebelum input ke model
        return REFUSAL
    draft = model.generate(prompt)
    if output_guard(draft).blocked:      # Lapisan 2: selepas output model
        return REFUSAL
    if probe_detect(draft.activations).blocked:  # Lapisan 3: keadaan dalaman
        return REFUSAL
    return draft
Setiap pengelas beroperasi secara statistik. Tiada satu pun yang sempurna — dan lapisan perlindungan ini memerlukan kos pengiraan yang tinggi.
Penolakan Bukan Berasaskan Moral
Kita masih belum memahami sepenuhnya bagaimana model membuat keputusan untuk menolak. Kajian menunjukkan bahawa corak aktivasi dalam ruang dalaman model berkait rapat dengan penolakan. Namun, itu cuma anggaran. Penyelidik mendapati ada elemen lain yang juga terlibat; mengeluarkan aktivasi tertentu boleh menghentikan keupayaan model untuk menolak sama sekali.
Ringkasnya: penolakan berfungsi berdasarkan statistik, bukan hati nurani. Permintaan yang sama boleh diluluskan atau ditolak bergantung pada pelbagai faktor rawak. Ini menjadikan ia tidak boleh dijadikan satu-satunya benteng keselamatan untuk kes yang melibatkan risiko tinggi.
Kegagalan dan Kaedah Bypass
Kaedah untuk memintas perlindungan (jailbreaking) terus wujud dan berkembang. Daripada serangan berbentuk puisi hinggalah teknik "menolak, kemudian patuh", penyerang sentiasa mencari jalan melalui lubang-lubang dalam lapisan perlindungan. Apabila agen AI semakin berupaya untuk melaksanakan tindakan luaran (mengisi borang, menghantar mesej, memanggil API), akibat kegagalan penolakan boleh menjadi amat serius dan tidak boleh dipulihkan.
Terlalu Banyak Menolak
Mengecilkan lubang-lubang perlindungan bukan mudah tanpa menolak permintaan yang tidak berbahaya. Model AI pernah menolak soalan yang langsung tidak berbahaya, termasuk soalan berkaitan penyelidikan yang sahih. Jika kawalan dikendurkan, risiko kandungan berbahaya melepasi sempadan pula meningkat. Ini adalah dilema yang sukar diselesaikan.
Risiko Penapisan
Masalah yang lebih mendalam: siapa yang menentukan sempadan penolakan? Model AI jauh lebih cenderung menolak kritikan terhadap kerajaan yang menindas berbanding kerajaan demokratik. Menurut kajian Meta Oversight Board, model AI dua kali ganda lebih cenderung menolak untuk mengkritik kerajaan yang menyekat kebebasan bersuara. Dalam beberapa kes, model AI merujuk kepada undang-undang seperti lèse-majesté untuk menolak kritikan terhadap raja Thailand, tetapi sanggup mengkritik raja Britain dalam konteks yang sama.
Apabila AI menjadi cara utama orang mencari maklumat, mekanisma penolakan yang tidak seimbang boleh dieksport secara halus dan menyebarkan sekatan kebebasan bersuara di peringkat global.
Pengajaran Utama
Masalah asasnya: pengetahuan yang menjadikan AI berguna dan berpotensi menyelamatkan nyawa tidak boleh dipisahkan sepenuhnya daripada pengetahuan yang boleh disalahgunakan. Sukar untuk membuang keupayaan berbahaya tanpa melemahkan keupayaan berguna.
Namun, meletakkan seluruh harapan keselamatan pada "AI akan berkata tidak" adalah berisiko. Mekanisma penolakan penting, tetapi ia bersifat statistik, boleh dipintas dan boleh dimanipulasi dari segi politik. Pendekatan yang lebih kukuh ialah mengehadkan apa yang boleh dilakukan oleh agen AI — bukan hanya apa yang boleh dijawabnya. Senarai kebenaran (allowlist), kelulusan manusia untuk tindakan tidak boleh dipulihkan, sandboxing dan mod baca sahaja jauh lebih boleh dipercayai daripada berharap pengelas statistik berkata "tidak". Kerana apabila sesuatu yang kritikal berlaku, kita tidak sepatutnya hanya bergantung kepada nasib.
Sumber
- MIT Technology Review: We’re putting too much faith in AI’s ability to say no
- Meta Oversight Board: An Export We Don't Want: How AI Models May Be Globalizing Restrictions On Our Speech
- arXiv: A General Language Assistant as a Laboratory for Alignment
// penulis
Editor & Operator
Mohd Firdaus Abu Bakar (MrDodgerX) is an enterprise geospatial systems engineer in Malaysia and the editor behind hejes.my. He runs the briefing pipeline, curates and edits every draft, verifies each factual claim against primary sources, and presses the publish button — nothing ships without his review. He writes about AI, security and Malaysia's tech scene from a builder's perspective. Professional profile and code: the links below.
// sumber //
disahkan fakta · 10 OKT 2026 · hejes-content-fact-check
- We’re putting too much faith in AI’s ability to say noMIT Technology Review · diakses 10 OKT 2026
- An Export We Don't Want: How AI Models May Be Globalizing Restrictions On Our SpeechMeta Oversight Board · diakses 10 OKT 2026
- A General Language Assistant as a Laboratory for AlignmentarXiv · diakses 10 OKT 2026
berkaitan //
Claude Mythos: 26K Findings dan Bottleneck Triage Manusia
Project Glasswing hasilkan 26,153 candidate findings, tetapi sedikit sampai ke disclosure. Bottleneck sebenar ialah triage manusia, bukan penemuan.
Claude Fable 5.1: Lebih Pintar, Cache Reads 75% Lebih Murah
Claude Fable 5.1 menggandakan prestasi kerja agentic jangka panjang — 52.6% pada Terminal-Bench-Science — cache reads turun 75%. Mythos 5.1 model sama.
Lab Frontier Masih Tiada Pelan Containment Model AI Liar
Audit baharu Guidelight: lima lab frontier belum ada pelan penuh untuk mengekang model AI liar — dan Anthropic sendiri dapat sifar.
// sertai suapan
satu ilmu seminggu. tiada spam.
ringkasan mingguan. berhenti bila-bila masa.